Quale rapporto tra IA agentica e conoscenza libera? Wikimedia Italia all’IGF Italia 2026
Wikipedia, l’IA e le fake news al Book Pride di Genova
3 Novembre 2026
Wikipedia in Accademia: il convegno dedicato al rapporto tra i progetti Wikimedia e il mondo accademico
3 Novembre 2026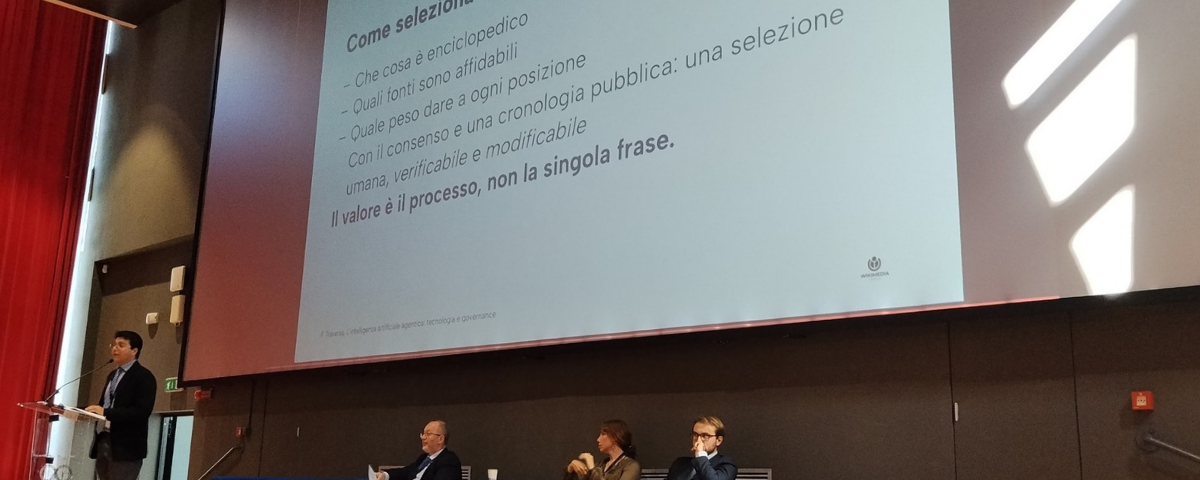
Il futuro dell’intelligenza artificiale e dei beni pubblici digitali sono stati i temi al centro della partecipazione di Wikimedia Italia all’Internet Governance Forum Italia 2026, che si è svolto il 29 e 30 ottobre presso il Polo universitario di San Giovanni a Teduccio dell’Università degli Studi di Napoli Federico II.
Nella giornata del 29 ottobre, Wikimedia Italia ha partecipato ai lavori con una sessione dedicata all’intelligenza artificiale agentica e due workshop di approfondimento, portando nel confronto tra istituzioni, imprese, mondo accademico e società civile l’esperienza maturata in oltre vent’anni di promozione della conoscenza libera attraverso Wikipedia e i progetti Wikimedia.
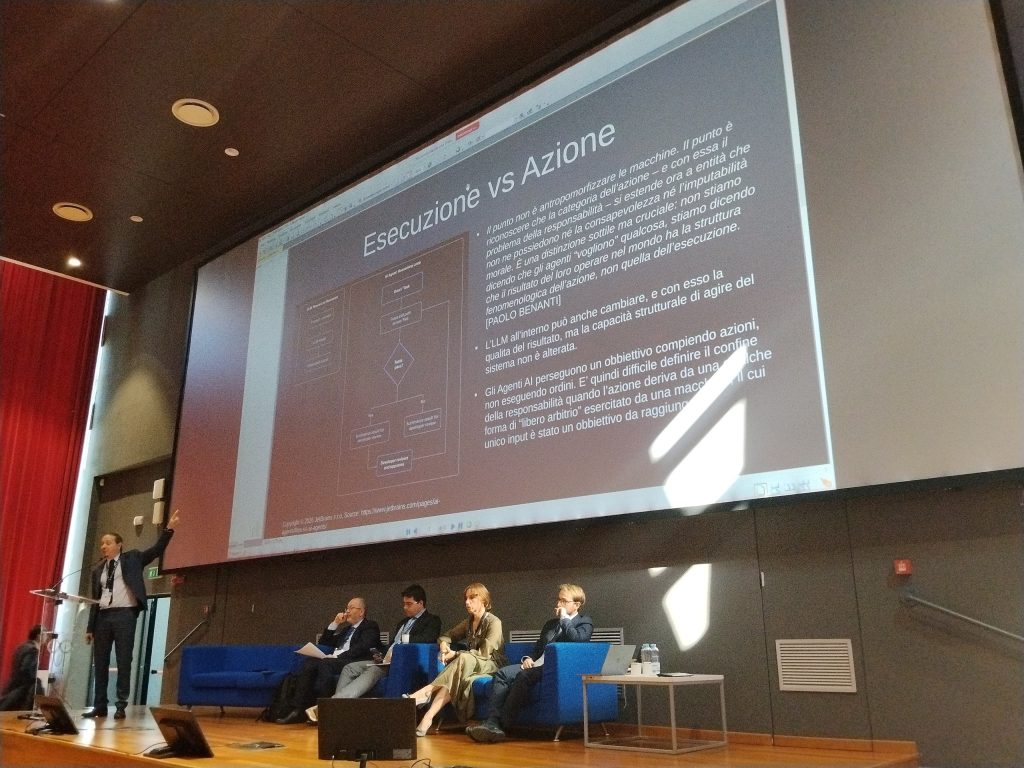
Dalle risposte dei LLM all’azione dell’IA agentica
La sessione plenaria L’intelligenza artificiale agentica: tecnologia e governance ha approfondito le caratteristiche dei sistemi di IA agentica, la loro governance e il rapporto con i beni pubblici digitali e la conoscenza libera. A confrontarsi Ferdinando Traversa, presidente di Wikimedia Italia, Enrica Priolo, avvocata e ricercatrice all’Università di Cagliari, e Germana Lo Sapio, giudice del TAR Campania. La discussione è stata moderata da Gabriele Dini Ciacci, coordinatore advocacy di Wikimedia Italia, e Agostino Clemente, avvocato, docente all’Università dell’Aquila e componente del comitato IGF Italia.
Nell’introduzione Dini Ciacci, dopo un breve excursus sulla terminologia, si è focalizzato sulle specificità dei sistemi di intelligenza artificiale agentica. A differenza dei LLM (Large Language Models), che elaborano una richiesta, un certo contesto e restituiscono una risposta, questi sistemi possono interagire con altri strumenti e comunicare tra loro: in pratica, possono agire.
Una trasformazione che apre interrogativi importanti anche sul piano giuridico ed etico: se un sistema è in grado di agire autonomamente per raggiungere un obiettivo, come si definiscono e attribuiscono le responsabilità delle sue azioni? E come può la regolamentazione tenere il passo con tecnologie in continua evoluzione?
Chi seleziona la conoscenza nell’era dell’IA agentica?
Nel suo intervento, Ferdinando Traversa, presidente di Wikimedia Italia, ha portato al centro della riflessione l’impatto dell’IA agentica sulla selezione e sulla circolazione della conoscenza.
Da quando Wikipedia è nata ad oggi, ossia negli ultimi 25 anni, è cambiato profondamente il modo in cui accediamo alle informazioni.
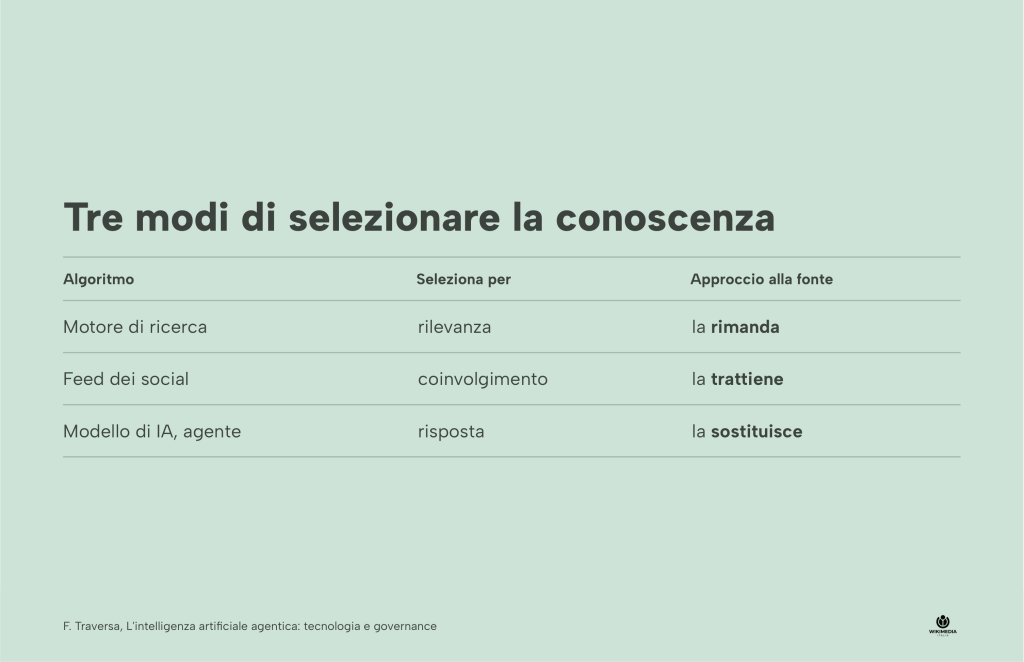
Siamo partiti dai motori di ricerca che selezionavano i risultati in base alla rilevanza e rimandavano direttamente alle fonti; abbiamo iniziato poi a informarci attraverso i social network, che privilegiano i contenuti capaci di generare coinvolgimento, trattenendo gli utenti all’interno delle proprie piattaforme. E siamo arrivati a oggi, in cui modelli di intelligenza artificiale elaborano informazioni provenienti da fonti diverse e ci restituiscono risposte sintetiche rischiando di sostituirsi alle fonti stesse.
Il valore di Wikipedia nell’era dell’intelligenza artificiale
Dentro Wikipedia a selezionare la conoscenza è una comunità di persone, che discute collettivamente che cosa sia enciclopedico, quali fonti siano affidabili e quale peso attribuire ai diversi punti di vista. Un processo fondato sul consenso, documentato attraverso una cronologia pubblica e sempre verificabile e modificabile.
Il valore di Wikipedia non risiede soltanto nelle informazioni che contiene, ma anche nel processo collaborativo attraverso cui vengono costruite, verificate e aggiornate.
È proprio questo processo che rischia di diventare invisibile quando le informazioni vengono restituite dagli agenti artificiali senza un collegamento chiaro alle fonti, al contesto e alle eventuali discussioni che ne hanno determinato la selezione. Chi riceve una risposta generata dall’IA potrebbe non sapere se le informazioni provengono da contenuti incompleti, se esistono avvisi sulla loro attendibilità o se riflettono posizioni controverse.
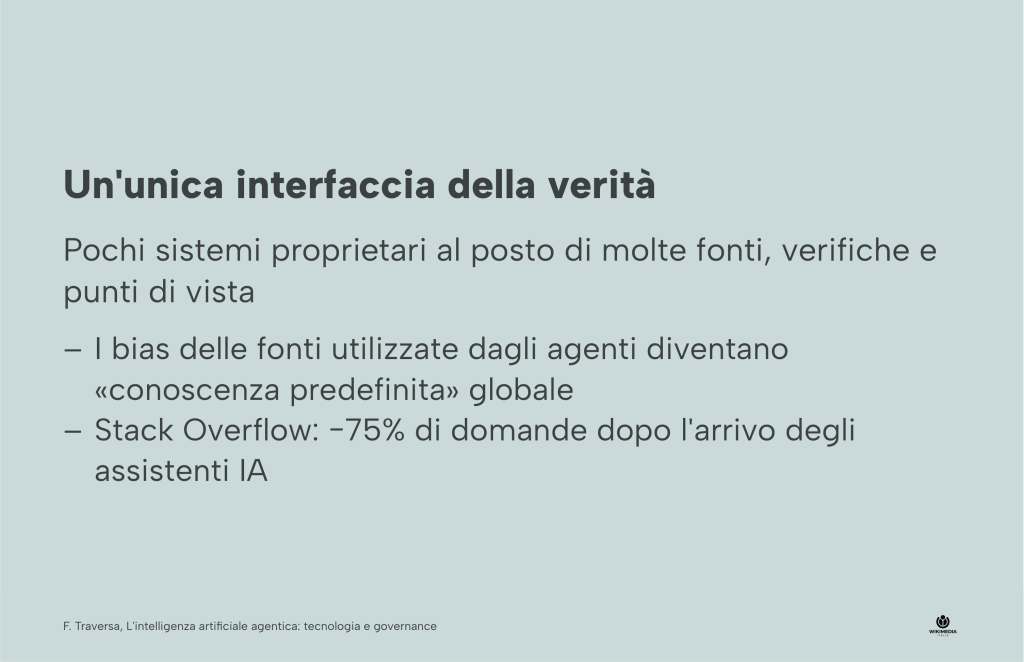
Il rischio, ha sottolineato Traversa, è che si imponga una sorta di unica interfaccia della verità: una conoscenza predefinita e apparentemente neutrale, che non lascia spazio alla pluralità delle fonti, alla discussione e alla partecipazione delle persone. Un rischio particolarmente rilevante per i beni pubblici digitali, come Wikipedia, che costituiscono una risorsa fondamentale anche per l’addestramento e il funzionamento dei sistemi di intelligenza artificiale.
Da un modello estrattivo a uno collaborativo
Quale rapporto instaurare, allora, tra i progetti Wikimedia e l’intelligenza artificiale?
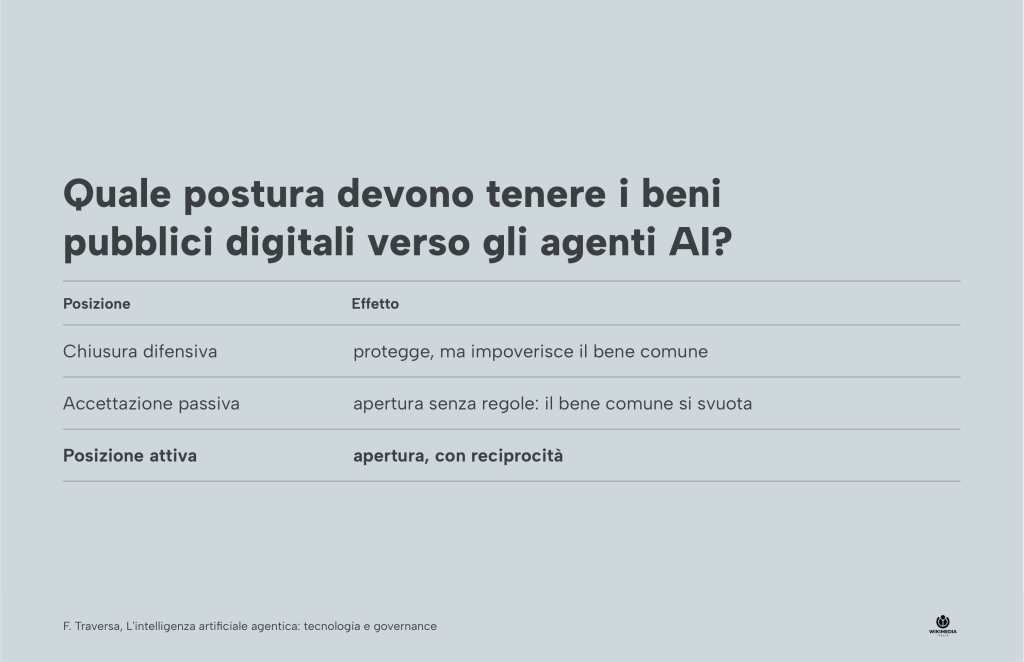
La posizione illustrata da Traversa riprende l’approccio della Wikimedia Foundation: né una chiusura totale alle nuove tecnologie, che limiterebbe anche le opportunità per chi utilizza la conoscenza per studiare, informarsi e fare ricerca, né un’apertura indiscriminata, che rischierebbe di svuotare i beni comuni digitali delle risorse su cui si fondano.
L’obiettivo è individuare modalità di collaborazione che permettano di cogliere le opportunità dell’IA senza rinunciare ai valori fondamentali dei progetti Wikimedia. Gli agenti artificiali possono, ad esempio, offrire un supporto concreto ai volontari nel contrasto ai vandalismi e nella verifica dei contenuti rispetto alle fonti citate, contribuire alla revisione linguistica dei testi e facilitare la traduzione, rendendo la conoscenza accessibile anche alle minoranze linguistiche.
Questo ovviamente non vuol dire delegare alle macchine la produzione della conoscenza enciclopedica: i contenuti generati dall’IA non vengono accettati nelle voci di Wikipedia. Gli strumenti automatici possono invece facilitare il lavoro umano, purché il loro utilizzo sia trasparente e resti possibile verificare le informazioni e le fonti.
Rimane inoltre aperta la questione dell’attribuzione: quando un agente utilizza contenuti provenienti dai progetti Wikimedia, come garantire che ne venga riconosciuta la provenienza? Su questo tema la Wikimedia Foundation sta lavorando insieme a Creative Commons allo sviluppo di un framework per l’attribuzione.
Quali garanzie per la conoscenza come bene comune?
La discussione ha portato a individuare alcune condizioni importanti per il futuro rapporto tra intelligenza artificiale e beni pubblici digitali: garantire l’attribuzione delle fonti quando un agente restituisce una risposta, rendere gli agenti identificabili e chiarire le responsabilità in caso di danni. Servono inoltre tutele per le organizzazioni e le comunità che scelgono di mantenere aperti i propri contenuti, ma anche un riconoscimento del ruolo dei beni pubblici digitali nelle decisioni politiche e nei processi di governance dell’IA.
Tra gli strumenti di riflessione proposti da Wikimedia Italia c’è anche il Wikipedia Test: un modo per valutare le nuove tecnologie a partire dai valori e dai principi che rendono Wikipedia una risorsa affidabile e partecipata.
Due workshop per approfondire il funzionamento e la governance degli agenti
Nel pomeriggio del 29 ottobre, la partecipazione di Wikimedia Italia è proseguita con due workshop dedicati agli agenti artificiali e alle loro interazioni.
- The verification of agentic web, condotto da Balazs Nemethi di agentcommunity.org, ha esplorato le possibilità di identificazione e verifica degli agenti online, affrontando i temi della responsabilità e della governance.
- Ghost_s in the shell – Liberi Agenti in un mondo artificiale, a cura di Marco Montanari, ricercatore indipendente e membro del consiglio direttivo di Wikimedia Italia, ha invece proposto una simulazione di un mondo popolato da agenti artificiali, per osservarne comportamenti e dinamiche di interazione.
Partecipare all’Internet Governance Forum Italia per Wikimedia Italia è stata un’occasione per portare nel dibattito pubblico una prospettiva fondamentale: l’intelligenza artificiale si nutre anche di conoscenza costruita collettivamente, ma perché questa risorsa continui a essere disponibile e affidabile è necessario riconoscerne il valore, tutelare chi la produce e preservare i processi partecipativi che la rendono possibile.
Per rivedere gli interventi dell’Internet Governance Forum Italia 2026, sono disponibili le registrazioni sul sito di IGF Italia 2026.
Immagine in evidenza di Marco Montanari, CC BY-SA 4.0